300 億參數壓進 20GB,你的顯卡就跑得動
Meta 開源 Muse Glimmer,本地代理人終於夠格用
如果你在用 AI 代理人寫程式,一直被雲端 API 的帳單追著跑,或是不放心把公司程式碼傳出去給模型供應商——Meta 8 月 10 日放出來的這個模型,第一次讓「自己在電腦上跑一個真正夠格的代理人」變成一個認真的選項。
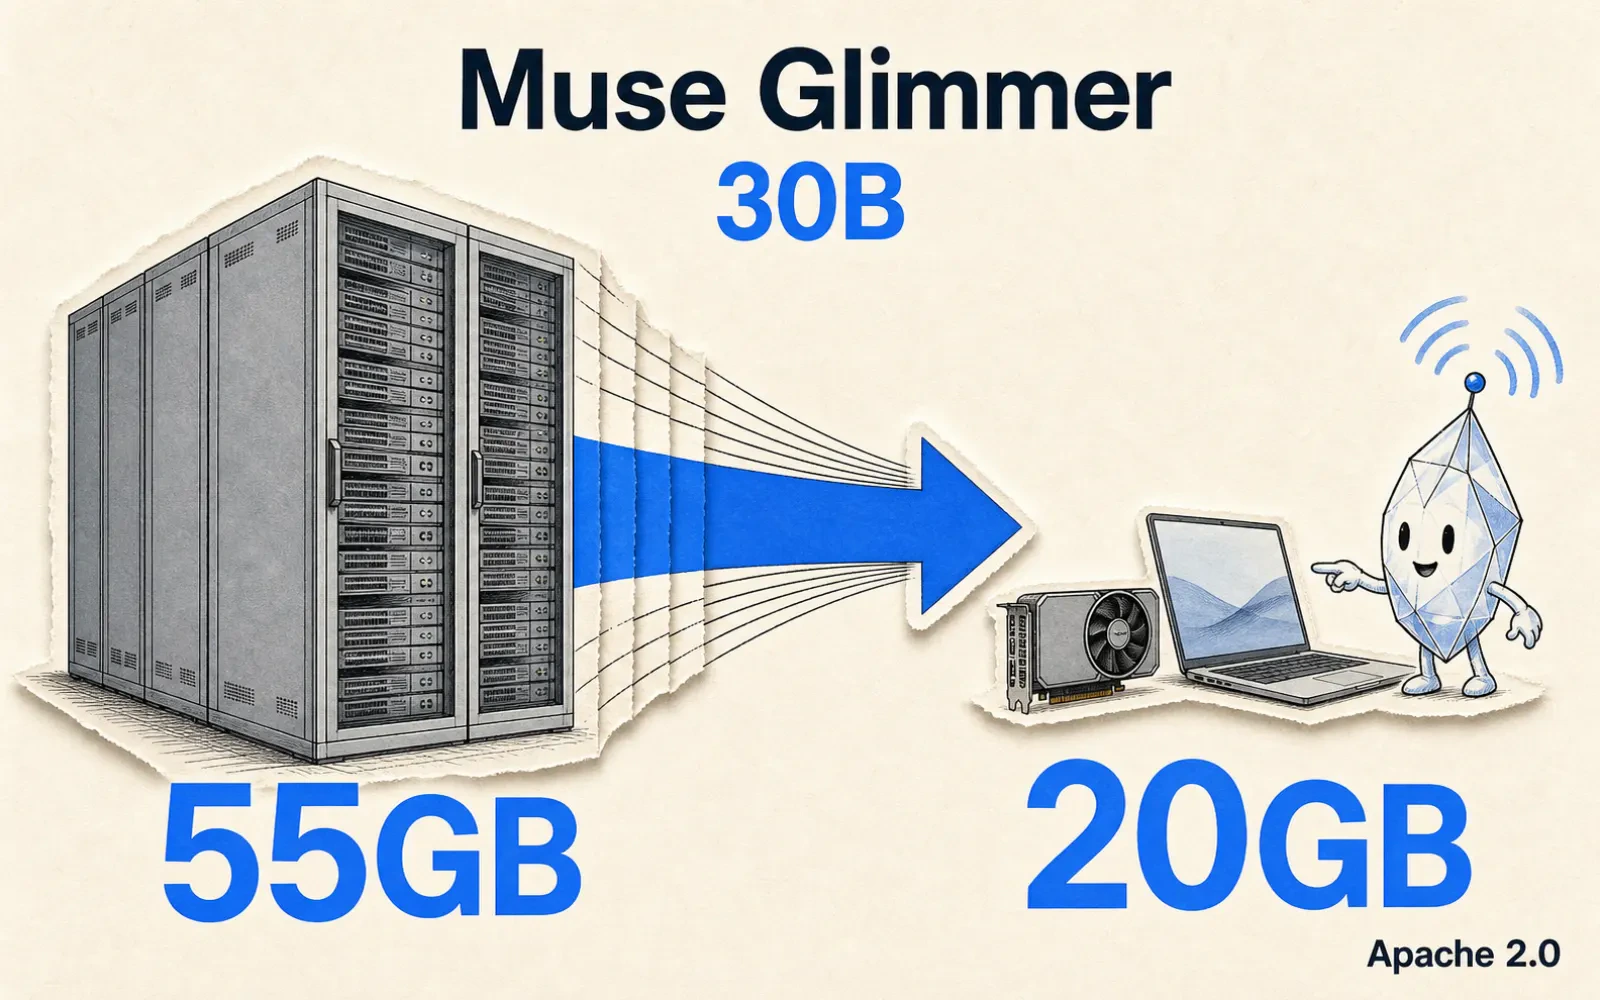
Muse Glimmer 是 300 億參數、Apache 2.0 授權的開放權重模型,官方把它定位成「本地代理人」專用:工具呼叫、多步驟任務、失敗後自己抓錯重來是訓練重點,不是聊天。原始精度要吃 55GB 以上的記憶體,官方用 4 位元量化把它壓到 20GB 以內,配合推測解碼(speculative decoding,先讓一個小型草稿模型生成候選 token,再由 Glimmer 驗證)加速,官方測出來在 RTX 5090 上快 3.1 倍、Mac M5-Max 快 1.8 倍、M4-Max 快 1.5 倍。20GB 這個數字剛好踩在許多消費級顯卡(24GB 那一檔)與 Mac 統一記憶體搆得到的位置——這不是巧合,是 Meta 挑的門檻。
能力上,官方公布的內部測試把它拿去跟 Gemma4-31B、Qwen3.6-27B 比了 24 項基準,Glimmer 贏了一半,項目包括線上研究、程式生成、科學圖表判讀——這是官方自報的數字,不是打平也不是全勝,是「同量級裡打得有來有回」。Ollama、LM Studio、vLLM、SGLang、OpenRouter 等平台發布當天就把它接了進去,也支援 OpenClaw 的 agent scaffold,代表你原本掛在某個代理框架上的流程,理論上換一個推理端點就能接上這顆本地模型。
這是 Meta 一年多來第一次重新放出開放權重模型——上一次引起這種規模討論的授權門檻爭議,我在 開放權重跟開源差在哪 那篇拆過。這次 Apache 2.0 是乾淨的商用授權,沒有附帶那些爭議條款,官方說法是準備恢復定期放出開放權重模型,下一版「很快」會來。有意思的對照是:同一個 Muse 家族,Muse Spark 才剛把最便宜的訂閱層改成用你的程式碼折抵運算費——一邊向用戶收費換算力,一邊把壓縮後的模型直接免費放出來,Meta 顯然把「開放權重」跟「訂閱定價」當成兩條不衝突的生意線在同時經營。
我的判斷是:20GB 這個數字比 Apache 2.0 授權本身更值得記。開放權重模型過去幾年一直卡在「權重是開的,但你的顯卡跑不動」——Muse Glimmer 是第一個把「一般人買得起的硬體」跟「打得贏商用等級對手的代理能力」放進同一個交集裡的版本。如果你的工作流已經在為 token 帳單煩惱,或者資料不能離開自己的機器,這是今年第一次值得認真評估「不用雲端」這個選項的理由。
查核備註:24 項基準測試的勝負分布是 Meta 官方公布的自測數字,我沒有獨立重跑;速度倍率(RTX 5090 3.1 倍、M5-Max 1.8 倍、M4-Max 1.5 倍)同樣是官方數字;我沒有實際下載跑過 Muse Glimmer,這篇是官方部落格與多方報導的文件檢視。
SOURCES
- AIntroducing Muse Glimmer: An Open Agentic Model That Runs on Your Device
- BMeta releases open-weights Muse Glimmer model with 30B parameters
- BMeta Publishes Muse Glimmer As 30B Open Agentic Model
來源分級:A = 一手公告/論文/官方文件 · B = 可信媒體 · C = 可參考但需脈絡 · D = 觀察用,不可當事實。
本文由 AI 與編輯共同撰寫,總編輯廖玄同審閱定稿。 編輯方針與 AI 使用說明