工具裝太多,AI 代理會漏掉該用的那一個
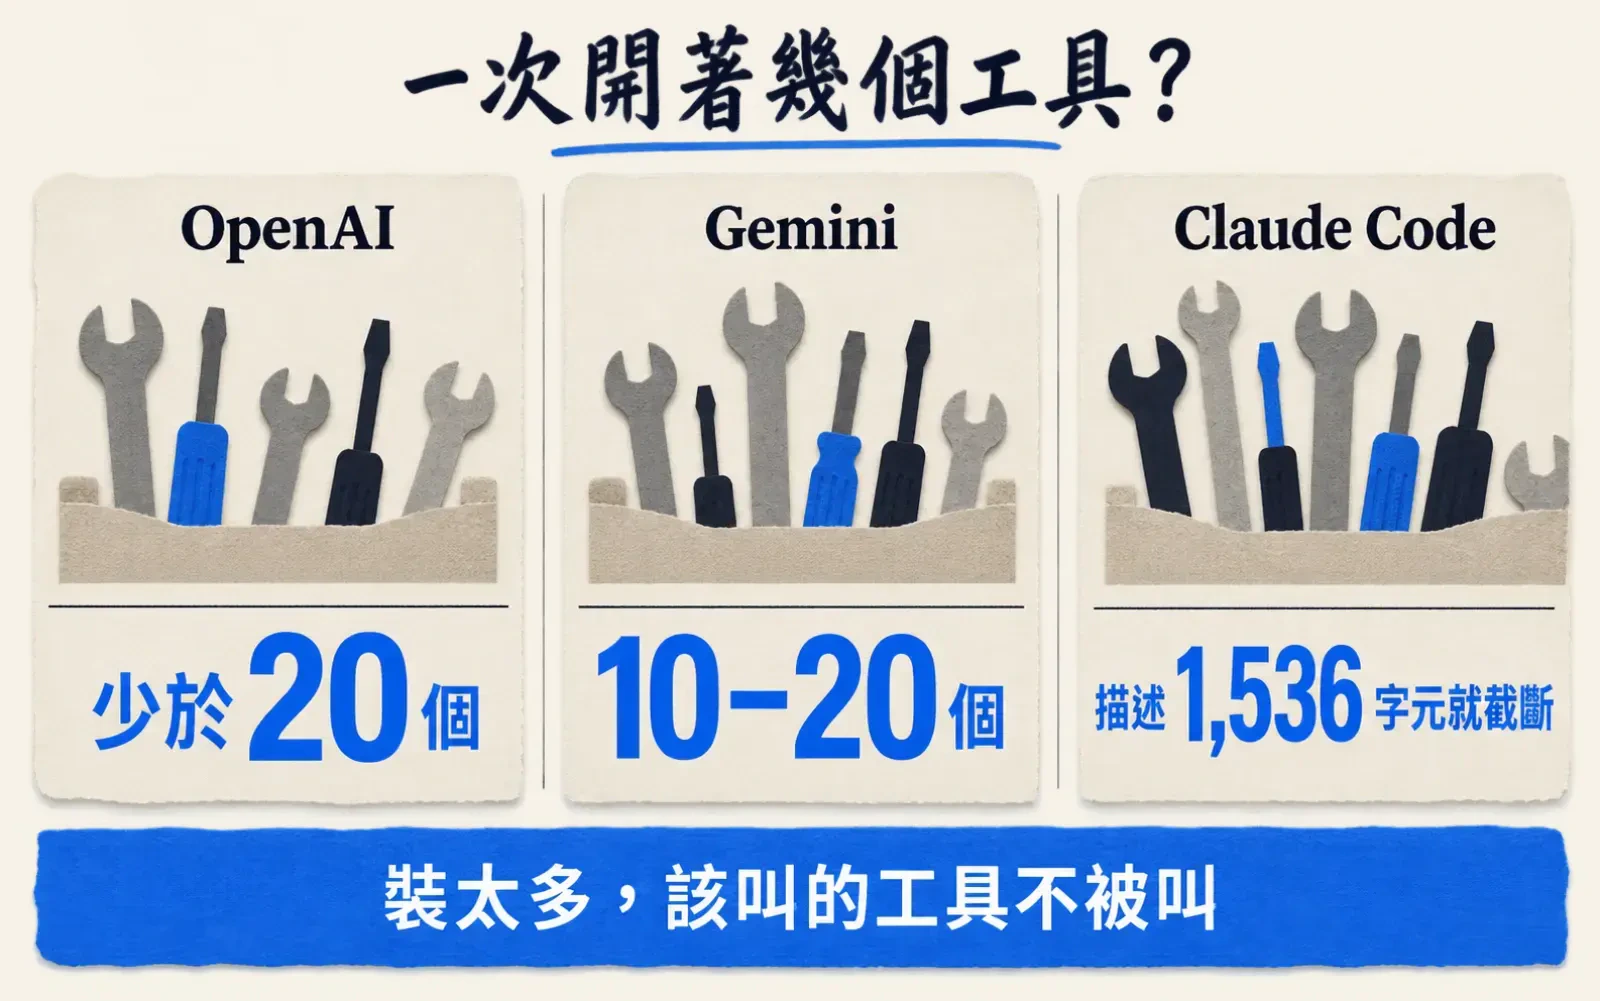
官方建議同時開著的控制在 10 到 20 個
你給 AI 代理接上的每一個工具、每一個 skill、每一台 MCP server,都在每一輪對話佔位子——不管這一輪用不用得到。裝太多的懲罰不是變慢,是該叫的工具不被叫。
工具定義是每一輪的固定成本
OpenAI 的函式呼叫文件寫得最白:函式定義會被塞進系統訊息,算進模型的上下文(context)上限,並以輸入 token 計費。Google 的 Gemini 文件同樣寫明,函式的描述與參數計入你的輸入 token 上限。Claude Code 是把所有 skill 的名稱與描述每一輪載進 context,文件直說:不管有沒有用到。
三家官方都給了數字
| 產品 | 官方文件怎麼寫 |
|---|---|
| OpenAI | 一輪開始時可用的函式「盡量少於 20 個」;少一點,準度較高 |
| Gemini | 只給當下相關的工具,理想上把啟用的一組控制在 10–20 個 |
| Claude Code | 描述與 when_to_use 合計超過 1,536 字元就截斷 |
OpenAI 給的理由不是省錢,是準度。你多裝的那幾個,是從「它認得出該用哪一個」那一格扣的。
塞不下時,是產品替你決定
三家的處置都寫在文件裡,也都不問你:截斷描述、要你自己縮短、或改用延後載入(OpenAI 的 tool_search)。被截掉的,正是模型用來比對你這句話的字。
沒有人給你那個數字
三家都只給建議值,沒有一家寫「超過會掉多少準度」。既然沒有數字可等,我的做法是把半年沒叫過的關掉、把長描述砍成一句話。這跟思考強度同一個形狀——你沒設定的地方都有預設值;方法論那一層在上下文工程,這篇只管塞不塞得下。
查核備註:三家行為全以官方文件為準,我沒有實測任何一款的截斷行為。Claude Code 文件今日未寫清單預算佔 context 的比例,故本篇不寫。各家的「一組多少個」是建議值不是硬上限。
LEARN
想系統性學會,不只看這一則?
Claude Code 教學:用終端 AI Agent 完成真正的工作
讓 Claude Code 在你的專案裡完成一個真實任務,而且控得住權限、驗得了 diff、管得住成本。
從第 0 課開始 →SOURCES
- AFunction calling — OpenAI API 官方指南(函式定義注入系統訊息、算進 context 上限並以輸入 token 計費;建議一輪開始時可用函式少於 20 個;tool_search 延後載入。2026-09-13 讀)
- AFunction calling with the Gemini API — Google AI for Developers 官方文件(函式描述與參數計入輸入 token 上限;建議只給相關工具、啟用的一組控制在 10–20 個。2026-09-13 讀)
- AAgent Skills — Claude Code 官方文件(skill 描述每一輪載進 context、不論是否使用;description 與 when_to_use 合計截斷於 1,536 字元;/skill-doctor 報告各 skill 的 context 成本與叫用次數。2026-09-13 讀)
來源分級:A = 一手公告/論文/官方文件 · B = 可信媒體 · C = 可參考但需脈絡 · D = 觀察用,不可當事實。
本文由 AI 協助研究與起草,矽基前沿編輯部編修,總編輯廖玄同審閱定稿。 編輯方針與 AI 使用說明