被擋下來的時候,分清楚是他忙不過來還是你衝太快
同一句稍後再試,兩種原因
如果你有一段跑代理迴圈的程式,它大概長這樣:收到錯誤就退避,睡一下,再試一次。收到什麼錯誤都一樣。
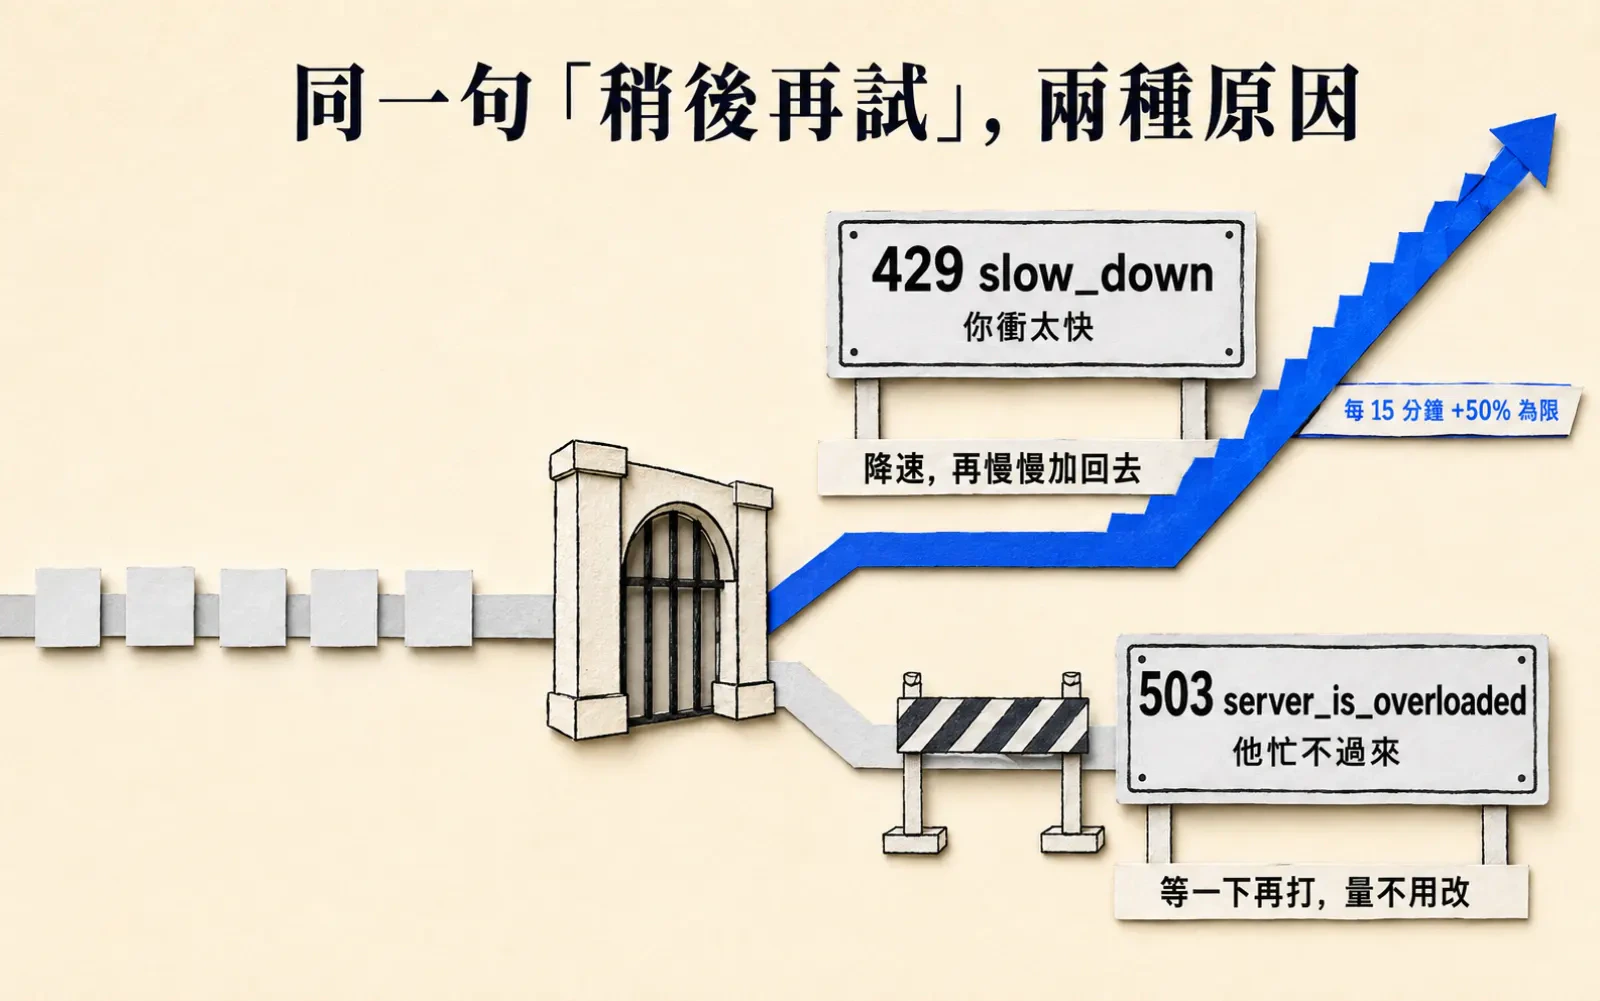
OpenAI 9 月 2 日把這件事拆成兩半。照官方 changelog 的說法,現在請求量拉升太快會回 429 並帶一個 slow_down 代碼,模型暫時過載則回 503 並帶 server_is_overloaded,兩者都可能附上 Retry-After 標頭。
差別不在錯誤碼好不好看,在於這兩件事該做的處置根本不同。過載是對方的狀況,你等一下再打就好,量不用改。slow_down 是你的狀況,睡一下再用同樣的量衝回去,只會再撞一次。
速率限制文件裡有一句話把這點講得更死:slow_down 就算你的流量還沒用盡每分鐘請求數與每分鐘 token 的上限,也可能出現——它反映的是流量增加得多快,不是你有沒有把額度用完。同一份文件給了一個可以直接抄進部署計畫的數字:流量到每分鐘一百萬輸入 token 之後,每 15 分鐘增加不要超過 50%。
這對誰有差?對排夜間批次的人差最多。你半夜三點把一整天累積的工作一次丟出去,從零衝到滿載只花幾秒,那正是這個錯誤在防的形狀。
值得一提的是,Anthropic 的錯誤文件早就是同一套分法,只是門牌不同:過載是 529 overloaded_error,而用量急遽上升撞到的加速限制回的是 429,官方的處方也一樣——逐步拉升、維持穩定的使用模式。兩家的分法一致,代碼不一致,所以你那段同時接兩家的錯誤處理,沒辦法用一個條件寫完。
錯誤碼分家之後,重試策略也該分家:一種是等,一種是慢下來再爬回去。把兩者塞在同一個 except 分支裡,等於對其中一半永遠開錯藥——而那一半是你自己造成的。
查核備註:兩家的行為我都沒有實際打到限制去驗證,全文依官方 changelog 與文件。OpenAI 沒有公佈 slow_down 的觸發門檻,那個「每 15 分鐘 50%」是官方給的建議上限、不是判定式。
SOURCES
- AChangelog(2026-09-02 條目)— OpenAI API Docs
- ARate limits — OpenAI API Docs
- AClaude API errors — Claude Platform Docs
來源分級:A = 一手公告/論文/官方文件 · B = 可信媒體 · C = 可參考但需脈絡 · D = 觀察用,不可當事實。
本文由 AI 協助研究,矽基前沿編輯部撰稿,總編輯廖玄同審閱定稿。 編輯方針與 AI 使用說明