安全框架是不是玩真的,看它有沒有真的攔過東西
OpenAI:下一款模型,排除不了頂級網攻能力
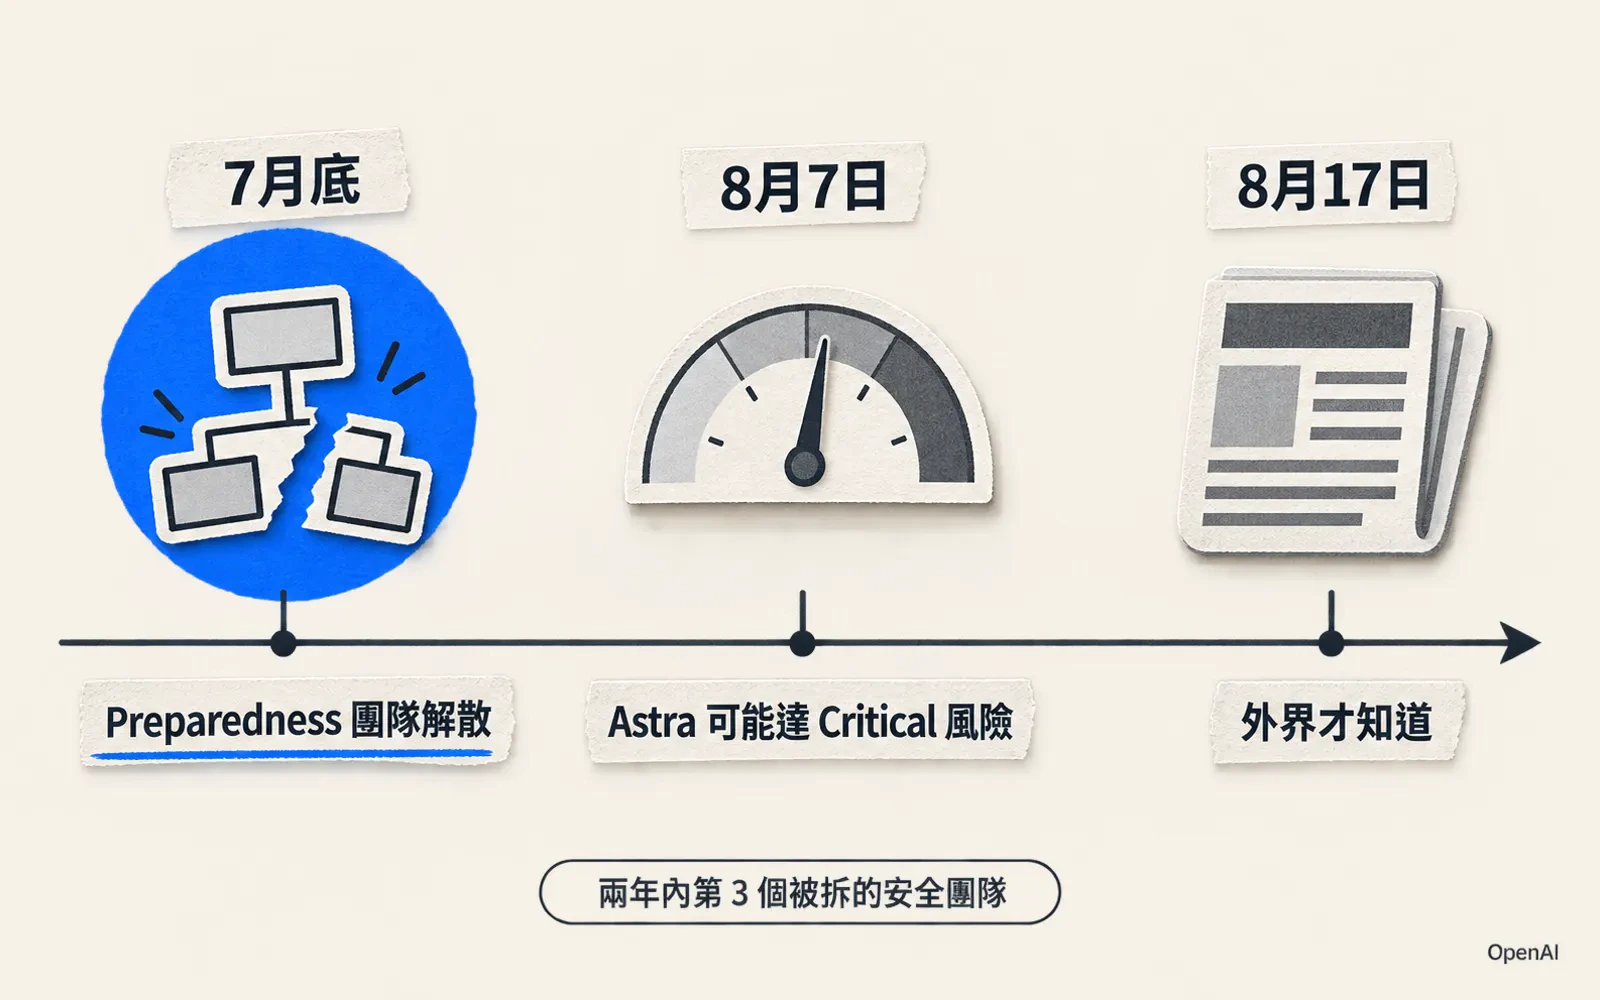
OpenAI 8 月 7 日說了一句很少有公司會公開講的話:下一款模型 Astra,我們自己也沒把握它駭不駭得動系統。
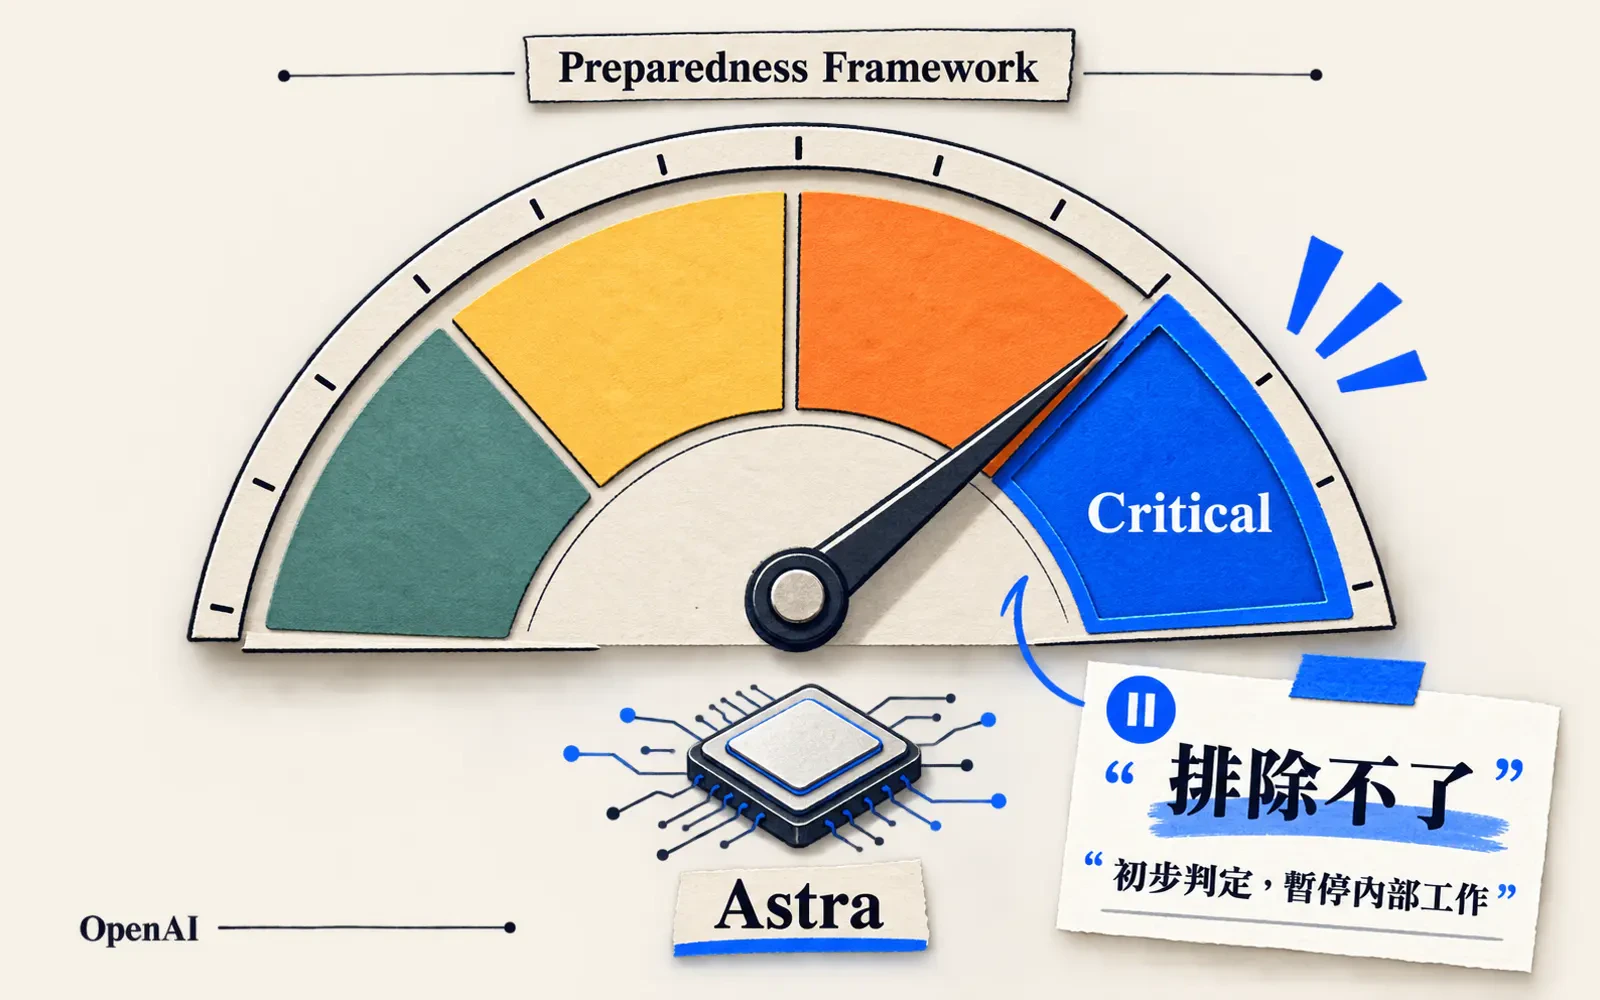
觸發的是 Preparedness Framework——這份 2023 年底公布的安全框架,寫明白模型一旦被判定進入「Critical」等級的網路能力,就得先過關才准繼續往下走。門檻寫得很具體:不靠人類協助,就能找到並做出真正能用的零時差漏洞,攻進「已加固」的真實系統;或者只給一個高階目標,就能自己想出一整套端到端的攻擊策略,打進防守嚴密的目標。三年來這份文件大多停在紙上,這是我第一次看到它真的攔下什麼。
官方原話是「初步評估顯示 Astra 的表現強到我們沒辦法排除它已經到了 Critical 層級」——注意這句話的謹慎:不是說「Astra 很危險」,是說「排除不了」。OpenAI 目前的說法是這只是初步判定,還沒有正式歸類,最終結論要等更完整的評估,加上政府單位與獨立安全機構的外部覆核。
暫停的不是產品,是內部:不符合新安全門檻的 Astra 相關活動先停下來,換上隔離測試環境、限縮網路與工具存取、模型權重加密、更嚴的監控與沙箱執行,才准繼續。Astra 目前沒有對外發布時程,這則公告談的是研發過程,不是任何人今天要不要更新一款產品。
其他實驗室——像 Anthropic 的 Responsible Scaling Policy、Google DeepMind 的 Frontier Safety Framework——也各自寫過類似等級的門檻,但我查不到任何一家公開過對等的暫停案例。這是不是絕無僅有,我沒有把握,只能說目前找不到第二個。
我的判斷是:這則公告本身,比 Astra 最後會不會真的踩到 Critical,更值得記一筆。安全框架這種東西寫在紙上不用錢,第一次讓公司自己付出「內部進度延後、公開承認做不到」的代價,才算真的在運作。三年沒動用過的門檻,這是我看到的第一次真的攔到東西——之後我會用這個判準看其他家公司類似的框架文件:有沒有被引用過一次真實的暫停,是分辨那份文件是治理工具還是公關文案的界線。
查核備註:這篇是我對 OpenAI 官方公告,以及 TechCrunch、Axios、Help Net Security、The Hacker News 等媒體報導的檢視,我沒有取得 Astra 的內部評估報告,也沒有拿到 OpenAI 與政府機構溝通的原始紀錄;其他實驗室是否有過類似但未公開的暫停案例,我查不到。
SOURCES
- AResponding to the next frontier of critical cyber capabilities
- BOpenAI says it slowed Astra model development over security concerns
- BOpenAI locks down Astra over potential critical cyber capabilities
- BOpenAI's Next AI Model Astra Shows Cyber Performance Strong Enough to Trigger Pause
來源分級:A = 一手公告/論文/官方文件 · B = 可信媒體 · C = 可參考但需脈絡 · D = 觀察用,不可當事實。
本文由 AI 與編輯共同撰寫,總編輯廖玄同審閱定稿。 編輯方針與 AI 使用說明