OpenAI 說解出十道數學題,數學家說:那段是我先證的
兩篇舊論文,官方悄悄改了用詞。
八月一日,OpenAI 說自家內部模型 Astra 解開了十道數學與理論計算機科學難題,多數主結果「至少十年沒人推進」。我們8 月 2 日拆過其中一份機器證書,當時的問題是「證書驗的是推導,不保證題目是原來那題」。現在,問題換了一個。
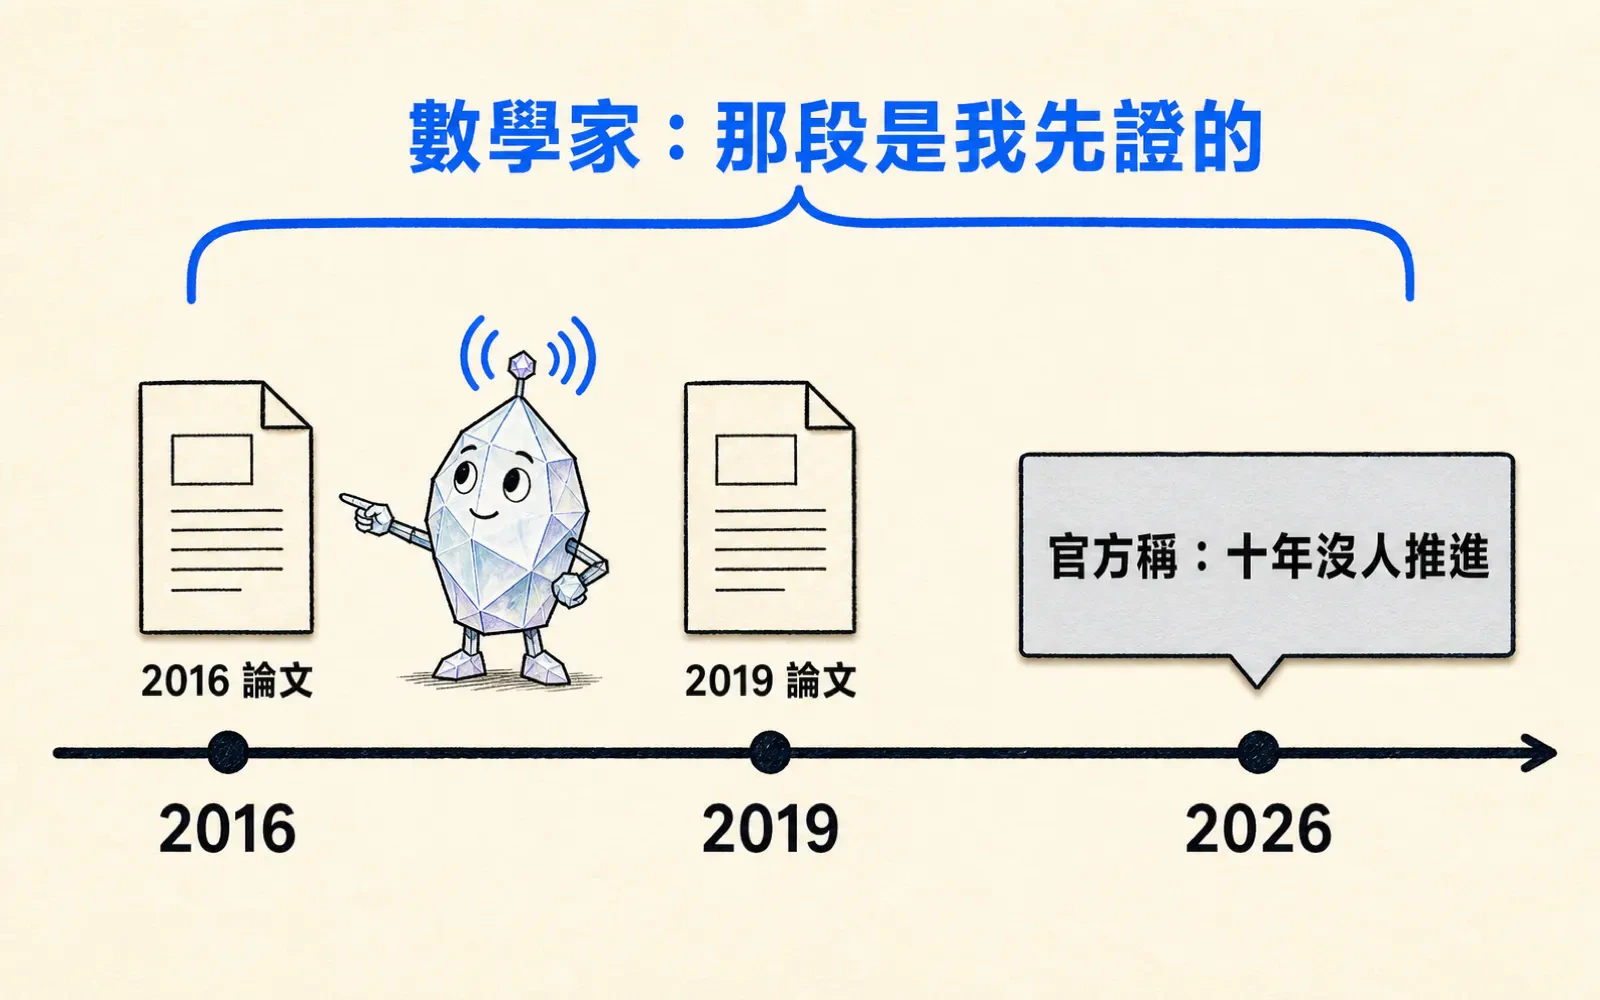
8 月 6 日起,兩位有名有姓的數學家公開站出來。Yeshiva University 的 Steven Miller 說,高維球堆積那道結果的論證,用的是他 2016 年那篇論文的做法——沒有列引用。他不留餘地:「他們是刻意在踐踏前人的工作」,這個模式「指向研究不端」。劍橋大學的群論學者 Francesco Fournier-Facio 講的是另一道題:non-sofic groups 的存在性證明,其實是拼接 2016 與 2019 兩篇既有論文的想法。他的用詞比較輕——「灌水」不是「造假」,矛頭指向的是「一台想聽起來越厲害越好的公關機器」。
兩人指向同一個破口。OpenAI 的公告寫「這些題目的主結果至少十年沒人推進」,但事實是這幾道題各自有 2016、2019 年的論文把關鍵步驟做出來了,只是沒被算進「推進」。據 Scientific American 與 AI Weekly 報導,被說破之後,官方公告的用詞已經悄悄改了。
OpenAI 的回應是:「我們對這些結果的正確性負責,標準比照人類數學家。我們這週會做一些小幅更新,照學界慣例來。」官方還搬出《萊頓宣言》——一份講研究者發表責任的國際數學聯盟文件——為「用部落格發表、不走同行審查」辯護。問題是,那份宣言原文警告的正是這種做法。
我認為:拿基準測試比較模型是一回事,拿「十年沒人解開的難題」當文案是另一回事——後者要背的查證責任,比公告的行銷語氣重得多。你如果在幫公司評估要不要跟進哪一家的「AI 做出重大突破」宣稱,這次的教訓很具體:先問這個結果有沒有具名的同行覆核、官方引用的規範文件自己怎麼說,再決定要不要當真。
我們7 月追過一次功勞怎麼記這條線——這次是同一個問題,換了兩個更大聲的名字。
查核備註:Miller 與 Fournier-Facio 的指控是他們的公開說法,我沒有獨立逐步比對 2016、2019 年那兩篇論文與 Astra 論文本體。OpenAI「這週會做小幅更新」是否已經執行、球堆積公告的用詞具體改了哪幾句,我目前查無官方版本紀錄可對,僅能引述二手報導的轉述。截至 8 月 1 日,Astra 的十道結果尚無獨立同行審查完成的公開紀錄。
SOURCES
- BOpenAI's latest math breakthroughs commit research misconduct, experts say — Scientific American
- BOpenAI's Astra math proofs draw research misconduct claims — AI Weekly
- COpenAI Astra's 10 Math Results: Evidence and Limits — Kingy.ai
來源分級:A = 一手公告/論文/官方文件 · B = 可信媒體 · C = 可參考但需脈絡 · D = 觀察用,不可當事實。
本文由 AI 與編輯共同撰寫,總編輯廖玄同審閱定稿。 編輯方針與 AI 使用說明