審查規則不用再重訓模型,寫成一句白話送進去就好
Mistral 的 Shieldstral,3B、Apache 2.0、圖文一起看。
你的產品如果要擋使用者貼進來的東西、或是檢查模型自己吐出來的東西,過去兩條路都不太舒服:接雲端審查 API,規則是別人的;自己拿開放權重的 guard 模型微調一版,每改一次政策就得重訓一次。
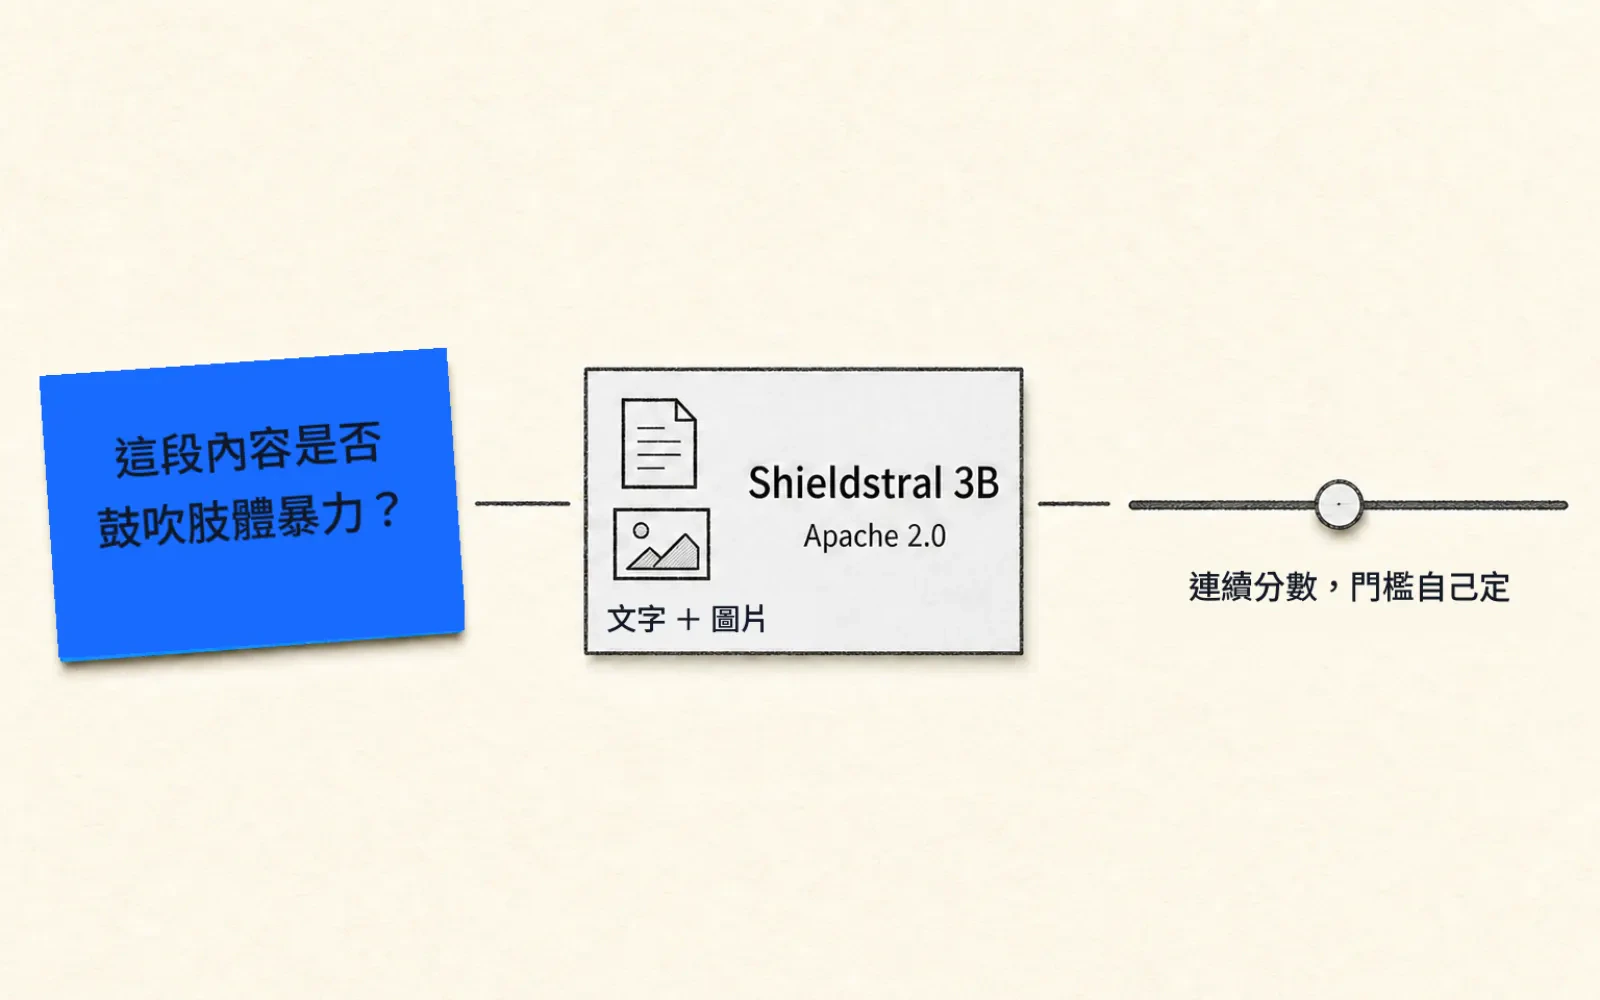
Mistral 8 月 4 日開了 Shieldstral,把政策搬到呼叫的時候才給。
輸入分三段:<Instruct> 講評判情境與嚴格程度、<Query> 是一個是非題(例如「這段內容是否鼓吹肢體暴力?」)、<Document> 放要判的東西,提示詞、回覆或圖片都行。輸出不是標籤,是 yes 和 no 兩個 logit 做 softmax 之後的連續分數,門檻你自己定。改政策等於改那句問句,不碰權重。
規格是 Shieldstral-1.0-3B:30 億參數、Apache 2.0、單張 16GB GPU 跑得動,權重放在 Hugging Face。官方稱它在文字安全、拒答偵測、政策適應、多模態四個面向上,追平或勝過體積達七倍的開源 guard 模型——但沒點名比較對象,也沒列出資料集。
台灣團隊先確認一件事:官方在文末自己寫了還在「繼續推進多語言覆蓋」,意思是多語目前列在待改進項裡。繁體中文判得準不準,你得拿自己的語料跑一輪才知道,別照著官方那句跑分排上線時程。還有一件我會先處理的事——這種「把政策寫成一句話送進去」的介面,本身就是 prompt injection 的攻擊面:被判的內容裡如果藏了指令,它跟你的政策問句待在同一個上下文裡。
查核備註:規格、介面與跑分出自 Mistral 官方公告與 Hugging Face 模型頁;跑分是官方自報,我沒跑過這個模型,也沒拿繁中語料測過它。
FAQ
常見問題
- Shieldstral 跟以前的 guard 模型差在哪?
- 政策的位置不同。傳統 guard 模型把審查分類寫進權重,改政策就要重新訓練或微調;Shieldstral 讓你在推論時用一句白話的是非題把政策送進去,模型回一個連續分數。改政策等於改那句問句,不必動權重。
- Shieldstral 支援繁體中文嗎?
- 官方公告沒有給出語言支援清單,並自陳多語言覆蓋仍在持續推進中。繁體中文的判準是否可靠,需要用自己的真實語料實測後才能決定要不要上線,不建議直接套用官方跑分。
SOURCES
來源分級:A = 一手公告/論文/官方文件 · B = 可信媒體 · C = 可參考但需脈絡 · D = 觀察用,不可當事實。
本文由 AI 協助研究與起草,矽基前沿編輯部編修,總編輯廖玄同審閱定稿。 編輯方針與 AI 使用說明