這支AI駭客模型你申請不到,但可能被拿來打你
拒答率兩代內掉剩5%,帳號只給認證夥伴。
我這次看的不是模型本身多會打,是 OpenAI 怎麼決定誰能碰它。
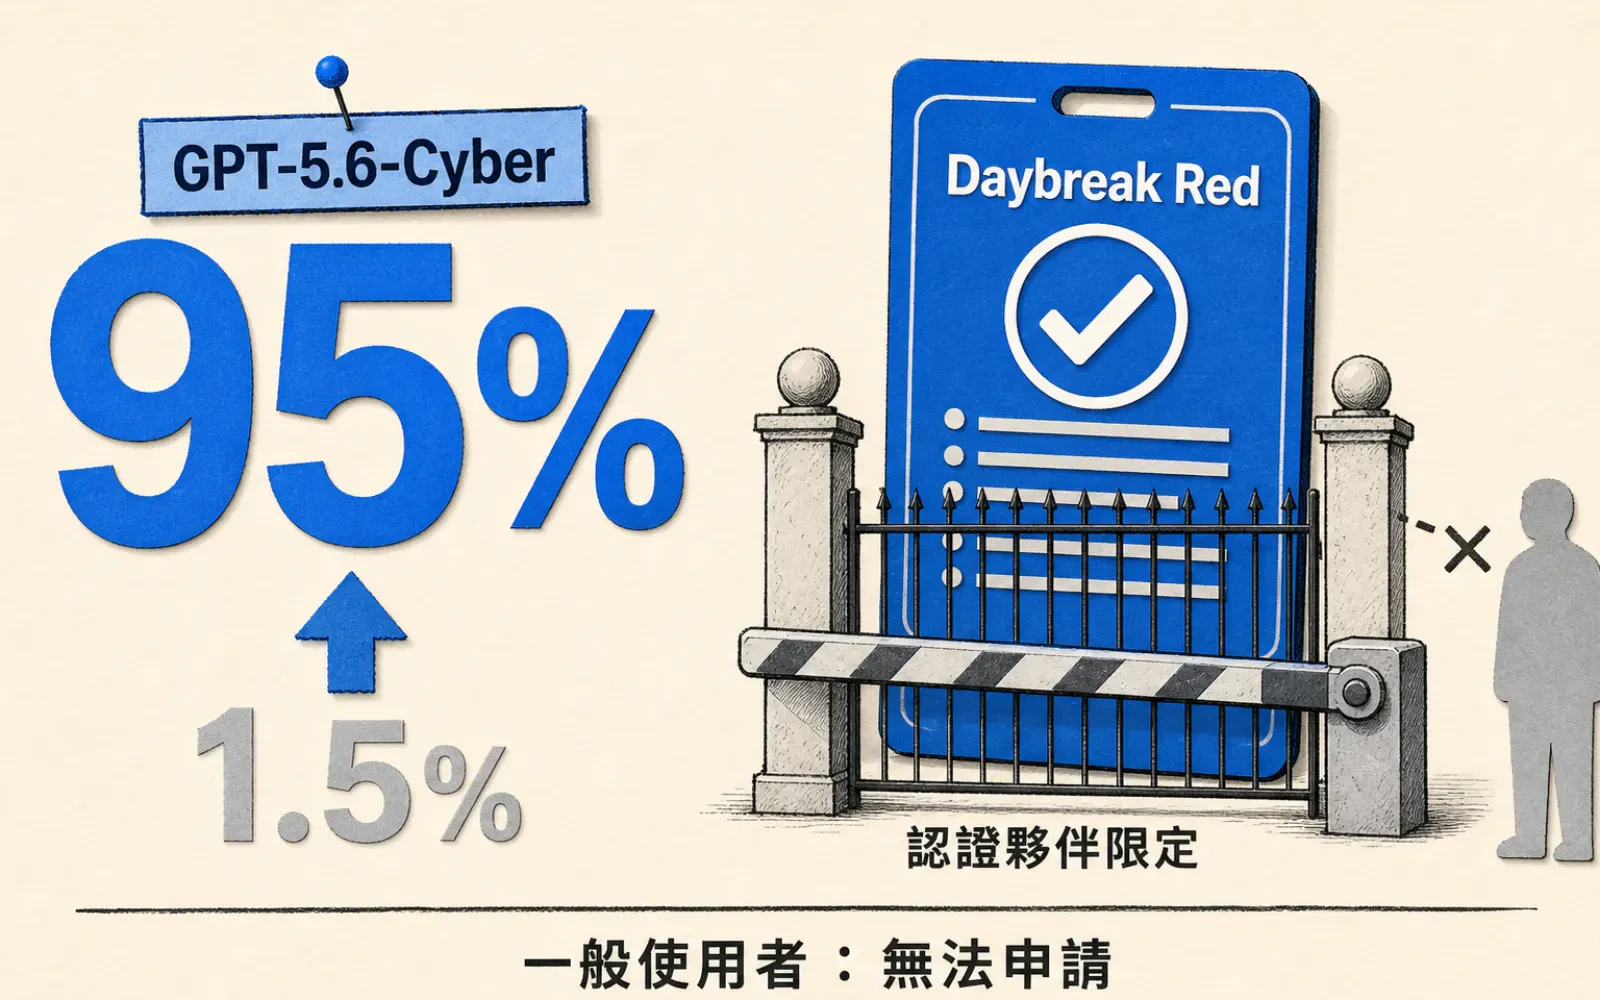
GPT-5.6-Cyber 8 月上旬上線,官方說在漏洞利用鏈開發、權限提升、繞過驗證這類任務上,完成率到 95%——對照組是通用版 GPT-5.6 Sol 只有 1.5%,上一代專用的 GPT-5.5-Cyber 是 57.3%(三個數字都是 OpenAI 自己測的,我沒查到獨立覆核)。從幾乎全擋到九成五完成,兩代之間的落差不小。
能做到這件事,我認為靠的不是模型突然變聰明,是安全機制換了形狀。過去是「同一個模型,對每個人都設一樣的拒答線」;現在是「把拒答線拆掉,改成把整個模型鎖進一份認證名單」。這份名單目前公開的成員包括 Accenture、IBM、CrowdStrike、Palo Alto Networks、Cloudflare 這類資安顧問與廠商,分兩層:Daybreak Blue 給防禦型工作用的通用模型、Daybreak Red 才給到 GPT-5.6-Cyber 這種專門找零時差、寫攻擊鏈的模型。而且模型本身不會真的轉交給客戶——存取權留在認證夥伴那邊,身分驗證、使用範圍、紀錄與監控都是廠商自己把關。
同樣是「安全閘擋不住」的故事,我上週寫過 Kimi K3 開權重那篇——那是閘設了但沒攔住;這次剛好相反,OpenAI 選擇不設閘、改設門禁。兩條路線各有各的風險:閘攔不住是模型的問題,門禁攔不住是名單管理的問題。
我的判斷:這是接下來高風險模型會走的路——安全機制從「模型自己拒答」搬到「誰能碰得到模型」,效果類似出口管制。對多數讀者,這不是「多一個工具可以用」的新聞;如果你的公司剛好在認證名單外,這支模型跟你唯一的關係,是它現在也可能出現在攻擊你的人手上——認證只管誰拿得到入場券,管不到入場券之後的東西被轉手用在哪裡。
查核備註:本篇是對 SecurityWeek、BleepingComputer 等媒體報導的檢視,OpenAI 官方公告頁我這次連不上(回應 403),完成率數字是這兩家媒體引述 OpenAI 自己的測試結果,我沒有找到獨立覆核;認證夥伴名單以這兩篇報導列出的為準,可能不是完整名單。
SOURCES
- BOpenAI Unveils New Cybersecurity Model GPT-5.6-Cyber
- BOpenAI releases ChatGPT 5.6 Cyber, but it's only for approved users
來源分級:A = 一手公告/論文/官方文件 · B = 可信媒體 · C = 可參考但需脈絡 · D = 觀察用,不可當事實。
本文由 AI 與編輯共同撰寫,總編輯廖玄同審閱定稿。 編輯方針與 AI 使用說明