Claude 讀到員工的問題之前,你的伺服器可以先擋——除非那是圖
准或不准,五秒內回。不能塗掉,只能整條擋。
員工在 Claude 裡按下送出、模型讀到那句話之前,中間現在可以插進你們自己的伺服器。
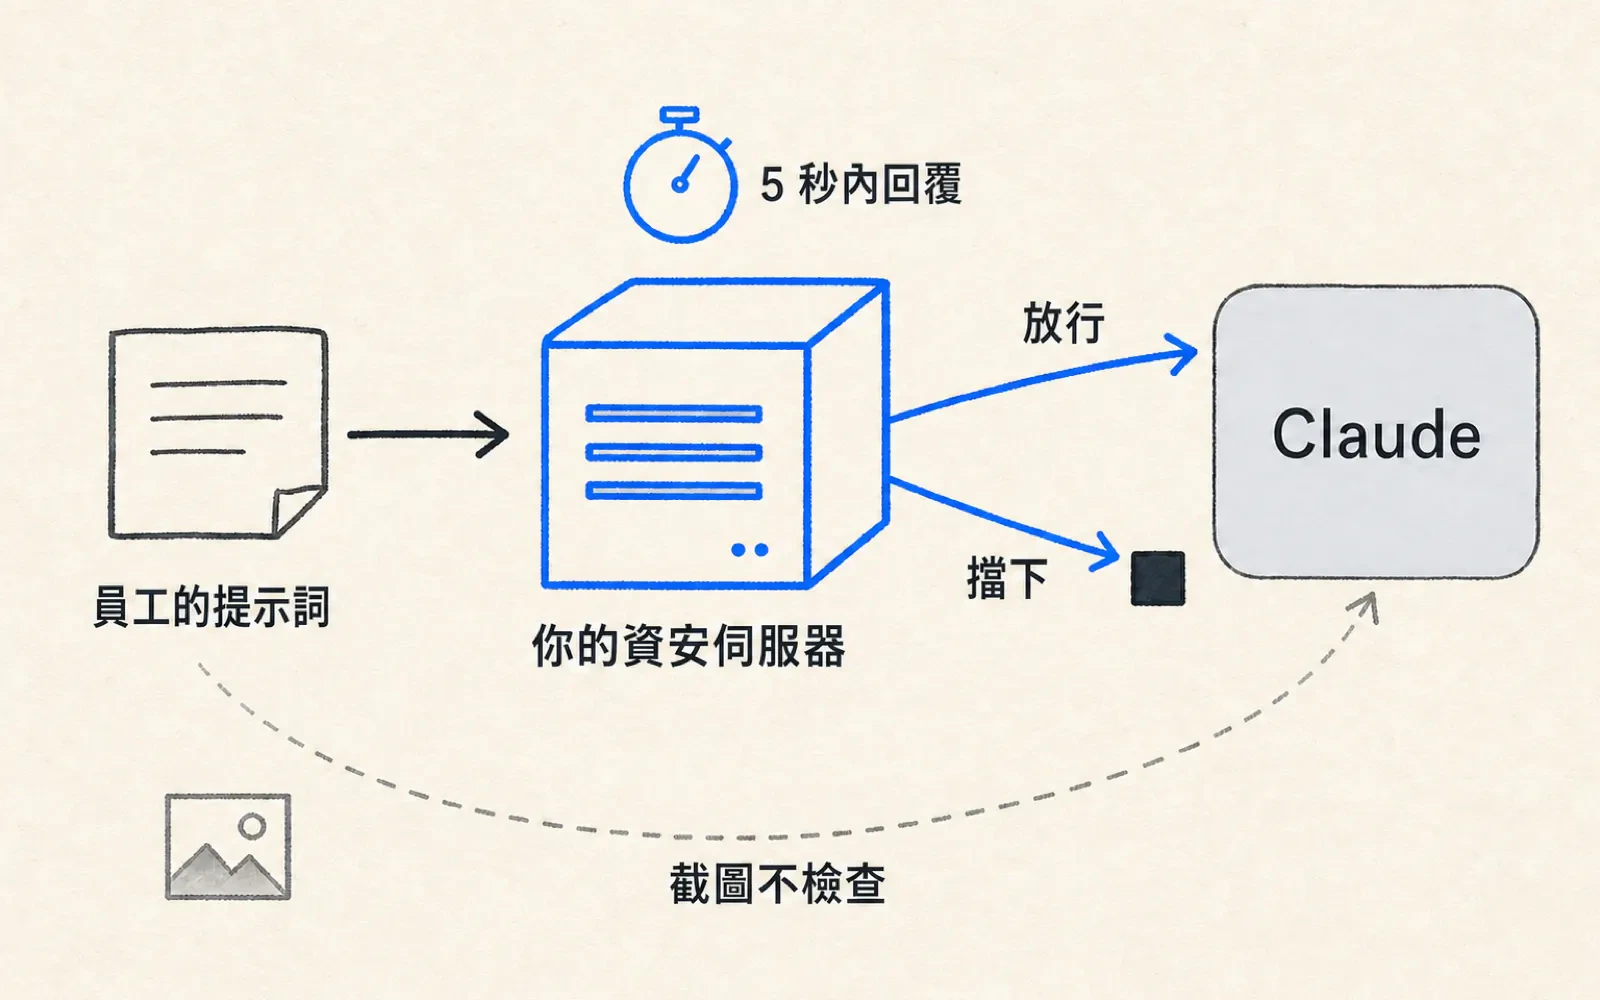
Anthropic 8 月 5 日開了 inference hooks(推論掛鉤)測試版,給 Claude 企業版。流程單純:使用者送出提示詞,Anthropic 把整段對話用 HTTPS POST 打到你指定的資安伺服器,等一個 allow 或 deny 的判決,預設等 5 秒、逾時長度自己設。判 deny 的請求根本進不到模型;使用者看到的擋下訊息由兩段拼起來,前半是你的伺服器在 deny_reason 裡寫的理由,後半是管理員設定的固定文案。每次拒絕都會進合規的 Activity Feed。請求照 Standard Webhooks 規格簽章,你驗得出來是不是 Anthropic 發的。
價值在位置。這道閘跑在 Anthropic 的機器上,在請求離開使用者電腦之後、模型跑之前,所以一個 hook 同時管住 claude.ai、Cowork 和 Claude Code,網頁、桌面 app、命令列都算,使用者的裝置上什麼都不用裝。這跟 Anthropic 七月給企業版加的花費上限與模型權限是同一個方向:管理動作從裝置端收回後台。
三個缺口,官方自己列在「Current limitations」底下。
它看不到圖。 伺服器收到的是對話文字、工具呼叫與工具回傳的結果、以及從附件抽出來的文字;原始檔案與圖片的位元組永遠不會送出去。把機密文件拍成截圖貼進去,不在檢查範圍內。
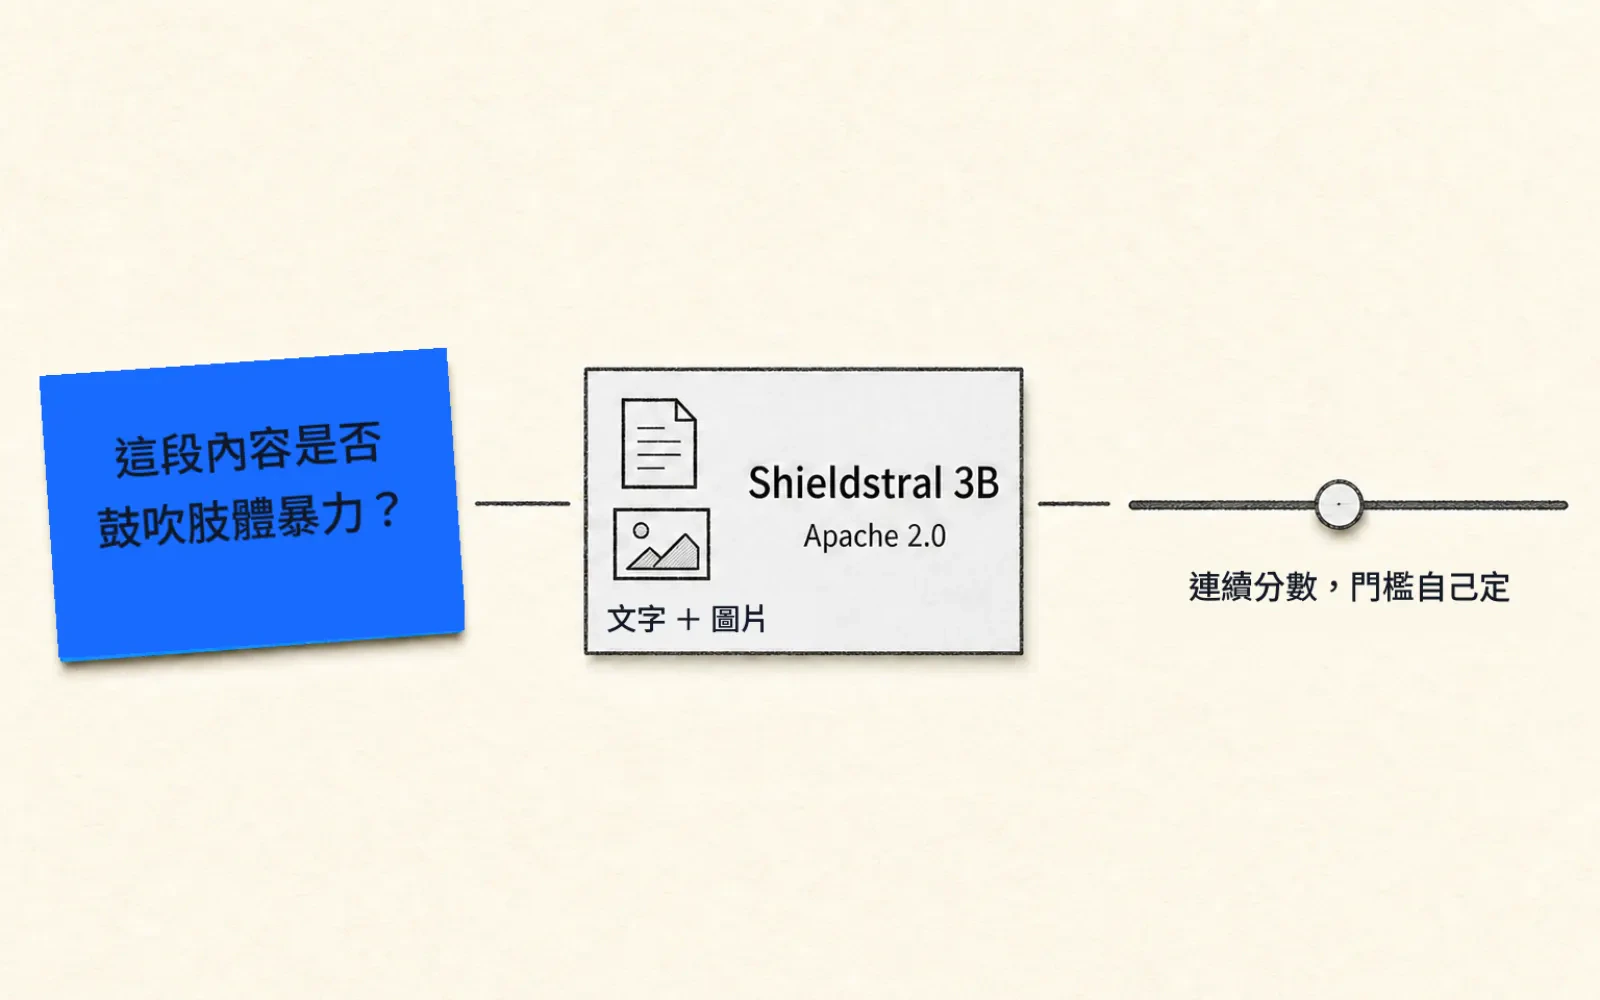
判決只有准跟不准。 不能改寫、不能把敏感欄位塗掉,要嘛整條放行、要嘛整條擋掉再叫使用者自己改。想要連續分數而不是二選一,Mistral 8 月 4 日開的 Shieldstral 是另一條路——但那是你自己接的審查層,不是模型商代你執行。
只有送出去那一側有閘。 官方寫明今天唯一的 hook 事件是 prompt,回應那一側是「planned as a later event」。模型吐出來的東西,這道閘不看。
其他邊界一次記完:Amazon Bedrock 和 Google Cloud 上沒有,走 API 的 Platform 組織不在範圍,語音模式不涵蓋,系統提示詞與工具定義從來不會被送出去。
有一件我覺得比上面三條更該先想清楚:代理流程裡,每一輪都是一次判決。 hook 綁的是推論請求,不是使用者發言——agent 每跑一輪就送一次,而工具回傳的結果會跟著下一輪的對話一起送去給你的伺服器看。好處是 MCP 連接器從內部系統撈回來的東西也過得了閘,代價是一個跑二十輪的任務要來回你的伺服器二十次。這是我從官方對 hook 事件與傳送內容的描述推出來的,不是官方說法;文件沒有談延遲成本。
所以真正要做的決定不是裝不裝,是那個開關扳到哪邊:你的伺服器連不上、回錯誤、或超過逾時的時候,是把請求擋下來,還是放它過去不檢查。官方兩邊都讓你選。選擋,資安伺服器一掛全公司的 Claude 就停;選放,合規紀錄裡就會有一段沒人看過的洞。shadow mode 只看不擋、按百分比抽樣、整批角色排除,這三個旋鈕是給你慢慢逼近答案用的,不是替你回答。
查核備註:規格、限制與預設值取自 Anthropic 官方文件與 8 月 5 日公告;我沒有 Claude 企業版可以實際佈一套來測。官方公告點名 Netskope、Palo Alto Networks、Proofpoint、Zscaler 可接,我沒查證這四家各自的接法。收費方式官方沒寫。
LEARN
想系統性學會,不只看這一則?
Claude Code 教學:用終端 AI Agent 完成真正的工作
讓 Claude Code 在你的專案裡完成一個真實任務,而且控得住權限、驗得了 diff、管得住成本。
從第 0 課開始 →SOURCES
- AInference hooks — Claude Platform Docs
- AInference hooks: inline data loss prevention for Claude Enterprise
- AClaude Platform release notes — August 5, 2026
來源分級:A = 一手公告/論文/官方文件 · B = 可信媒體 · C = 可參考但需脈絡 · D = 觀察用,不可當事實。
本文由 AI 與編輯共同撰寫,總編輯廖玄同審閱定稿。 編輯方針與 AI 使用說明