AI 代理上網查到的資料,是誰抓的、放多久了
四份官方文件裡,快取都是預設值
我最近在調一個代理的查資料流程,順手把它用到的幾個工具的官方文件從頭讀了一遍。想弄清楚的只有一件事:「上網查一下」底下,實際上發生了什麼。
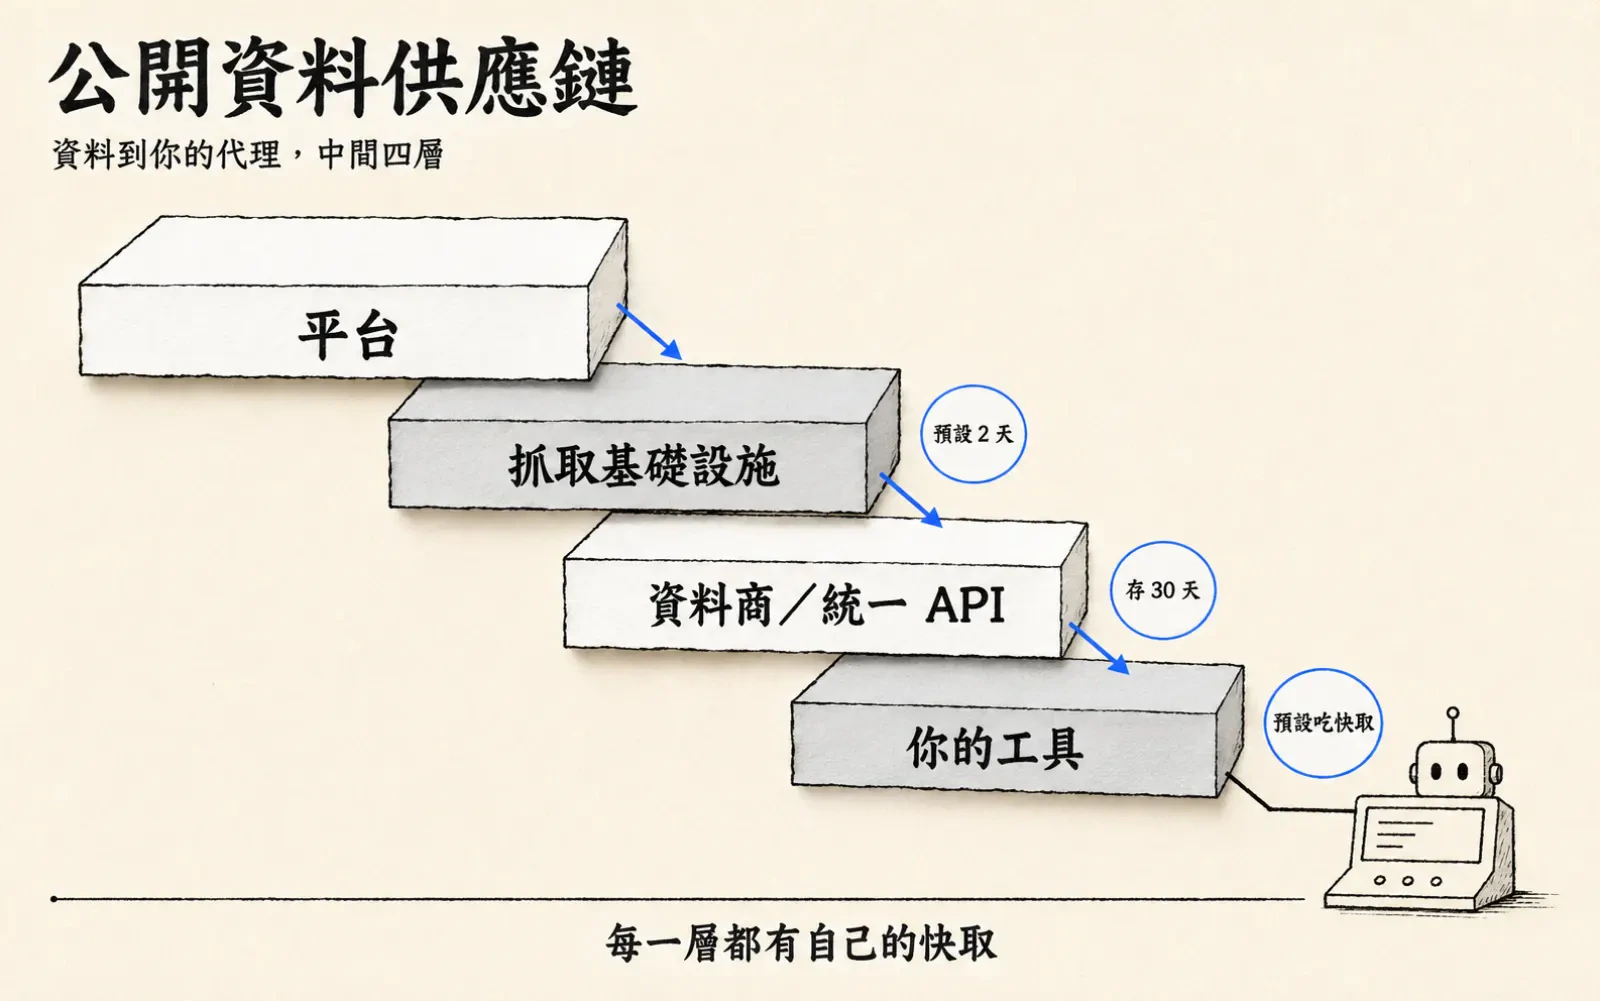
那份資料在進到代理的上下文之前,通常已經過了四層,每一層都有自己的快取規則。
公開資料供應鏈指的是:一份公開資料從它原本住的地方,到出現在你的代理眼前,中間經過的每一層服務。
這條鏈跟你的關係只有兩件事:你讀到的東西是誰抓的,以及它放多久了。
第一層:資料原本住的地方,現在有門房
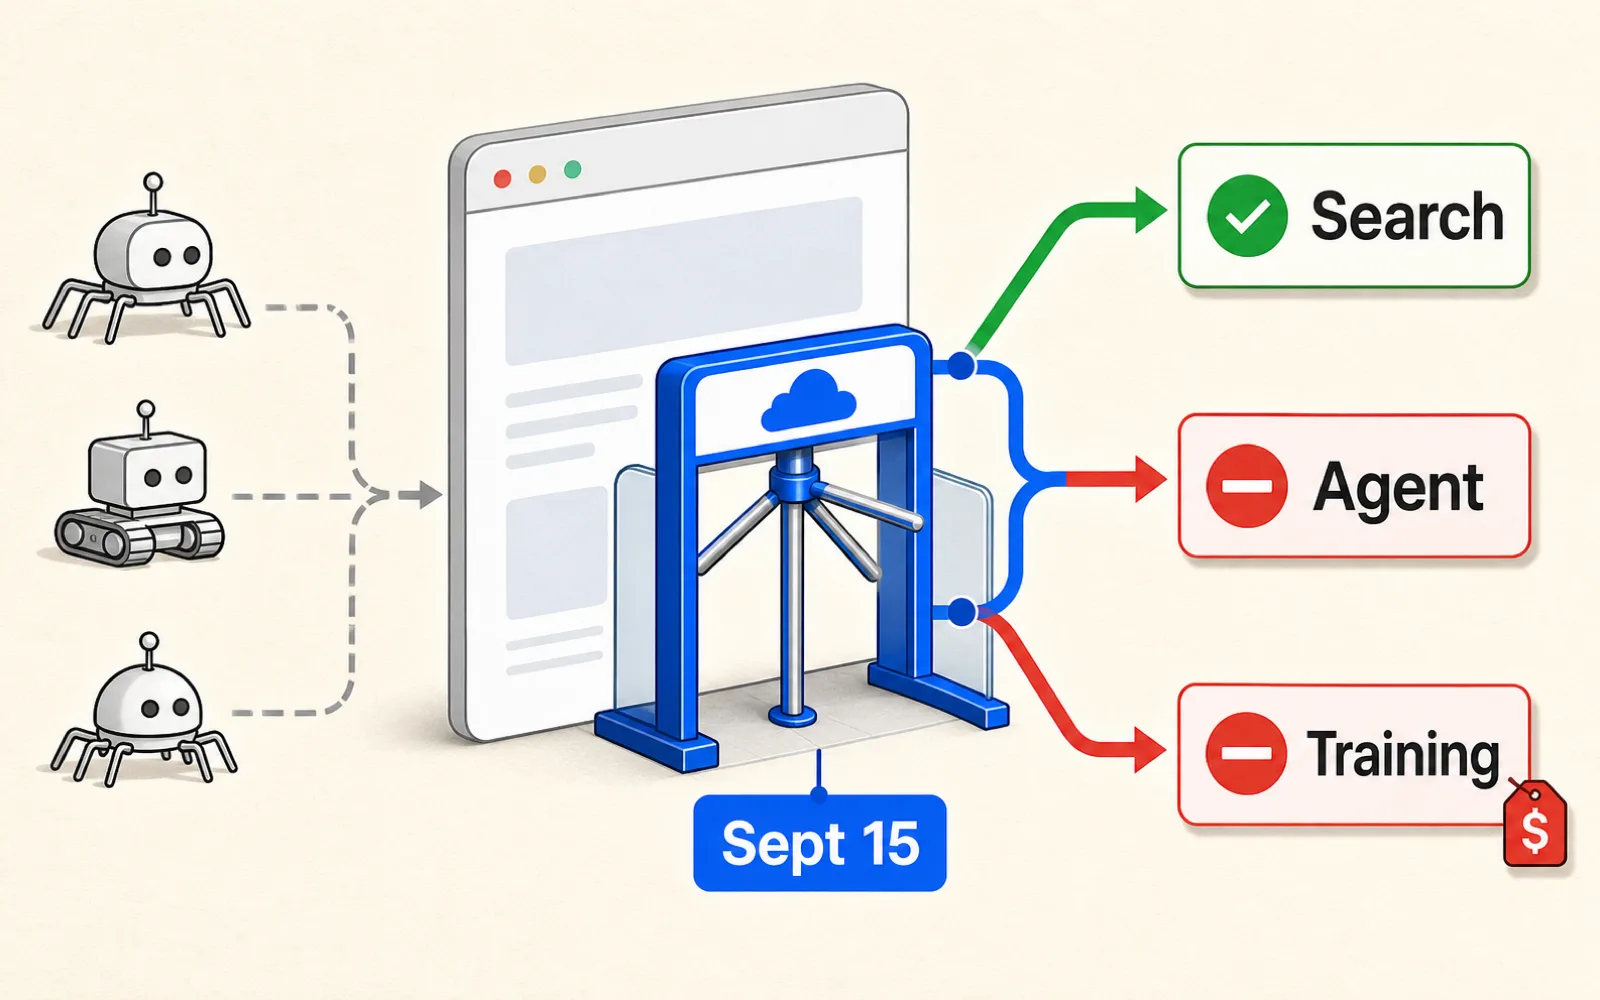
Cloudflare 的 AI Crawl Control 是這一層現在最常見的形狀:站方可以對個別爬蟲逐一設放行或封鎖規則。
對你來說,這一層不會回你一個「你被擋了」,它只會讓下游某一天開始查不到某個站(AI 爬你的網站,Cloudflare 讓你分三種處理)。
第二層:誰去按下那個請求
Firecrawl 自陳處理的就是「proxy、反機器人、JavaScript 渲染與動態內容」。
同一份文件裡,maxAge 的預設值是 172,800,000 毫秒,換算就是兩天。快取命中的結果一樣扣 1 點,快取改善的是速度與延遲,不是點數消耗。
你可能付了全額,拿到一份兩天前的頁面,而且沒有任何地方會提醒你。
第三層:資料商與統一 API
DataForSEO 的文件把時效寫在方法名稱上:Standard 方法的結果會保存 30 天,Live 方法的結果不保存。
Tavily 的官方說明頁寫的是單次 API 呼叫最多聚合 20 個網站。但我查不到一句話說明那 20 個網站是從自有索引來的,還是向第三方搜尋供應商調的。
文件會告訴你格式、額度與速度,很少告訴你上游是誰。
第四層:你自己接的那個工具
最靠近你的一層,是模型內建的工具或你裝的 MCP server(什麼是 MCP)。以 Anthropic 的兩個官方工具為例。
web search 回傳的每一筆結果帶一個 page_age 欄位,寫的是該網站最後更新的時間。但整份文件沒有一句話說明那個搜尋索引來自誰。
web fetch 會快取,官方文件自己寫明「回傳的內容不一定反映該網址上可取得的最新版本」。要新鮮內容得明確把 use_cache 設成 false。
第四層其實是整條鏈裡唯一一層,會主動告訴你「我給你的可能是舊的」。
接任何一家之前查得到的五個問題
- 這一層自己抓不抓? 去隱私政策或資料聲明裡找上游供應商名單。
- 回我的是現抓還是快取?預設是多久? 找不到那一行,就當作有快取而且你控制不了。
- 快取命中要不要照樣算錢?
- 它認不認 robots.txt? 這決定法遵責任落在誰身上。
- 我的請求與結果被存多久?
我自己改了什麼
我對自己的代理只改了一件事:把「這件事需要多新」寫進工具設定,而不是留給預設值。查價格、查條款、查今天發生的事,強制繞過快取;查定義、查規格、查歷史,讓它吃快取沒關係。
預設值是別人替你做的時效決定。它通常很合理,但它不知道你在查什麼。
查核備註:四層的說法是我為了講清楚而分的,不是任何官方文件的分類。Firecrawl 與 Tavily 的公開文件都沒有說明自己是否自營索引或向第三方調資料,本文不推論。上述規則全部來自各家官方文件,我沒有實際跑測試驗證,也沒有向任何一家求證。
FAQ
常見問題
- AI 代理「上網查資料」時,資料實際上是從哪裡來的?
- 通常經過四層:①資料原本住的平台或網站;②真正去發出請求的抓取基礎設施(代理 IP、反機器人處理、JavaScript 渲染);③把結果轉賣或聚合起來的資料商與統一 API;④你自己接的工具層,例如模型內建的 web search/web fetch,或一個 MCP server。你付錢的那一層不一定是真正去抓的那一層——服務商的法律文件與隱私政策才會寫清楚上游是誰。
- 代理查回來的網頁內容一定是最新的嗎?
- 不一定,而且快取在多數地方是預設值。Anthropic 的 web fetch 官方文件明寫回傳內容不一定反映該網址上的最新版本,要新鮮內容得把 use_cache 設成 false;Firecrawl 的預設新鮮度是兩天,兩天內的快取副本會直接回給你,而且一樣計費。要判斷時效,先去看該工具文件裡的快取預設值那一行。
SOURCES
- AWeb fetch tool — Claude Platform Docs
- AWeb search tool — Claude Platform Docs
- AFast scraping / caching(maxAge 預設值)— Firecrawl Docs
- AIntroduction — Firecrawl Docs
- AAbout Tavily — Tavily Documentation
- ADataForSEO API v3 文件(Standard 與 Live 方法)
- AAI Crawl Control — Cloudflare Docs
來源分級:A = 一手公告/論文/官方文件 · B = 可信媒體 · C = 可參考但需脈絡 · D = 觀察用,不可當事實。
UPDATE HISTORY
- First published.
- 依 EDITORIAL-SIGNALS §4 長度上限瘦身(2026-09-17 健檢裁示):2137 → 968 漢字,只刪不加——砍暖身段、第二種說法與旁枝;事實、數字、立場與查核備註未新增。砍前全文見 docs/content/signals-submissions/_trim-2026-09-17.md 所指的 git 歷史。
本文由 AI 協助研究,矽基前沿編輯部撰稿,總編輯廖玄同審閱定稿。 編輯方針與 AI 使用說明