六款 AI 代理的核可鍵,防不住一個符號連結
核可的是資料夾,不是每個檔案
我這次拆的是一個很基本的信任機制:你按下「核可」的時候,代理做的事跟你以為的是不是同一件。
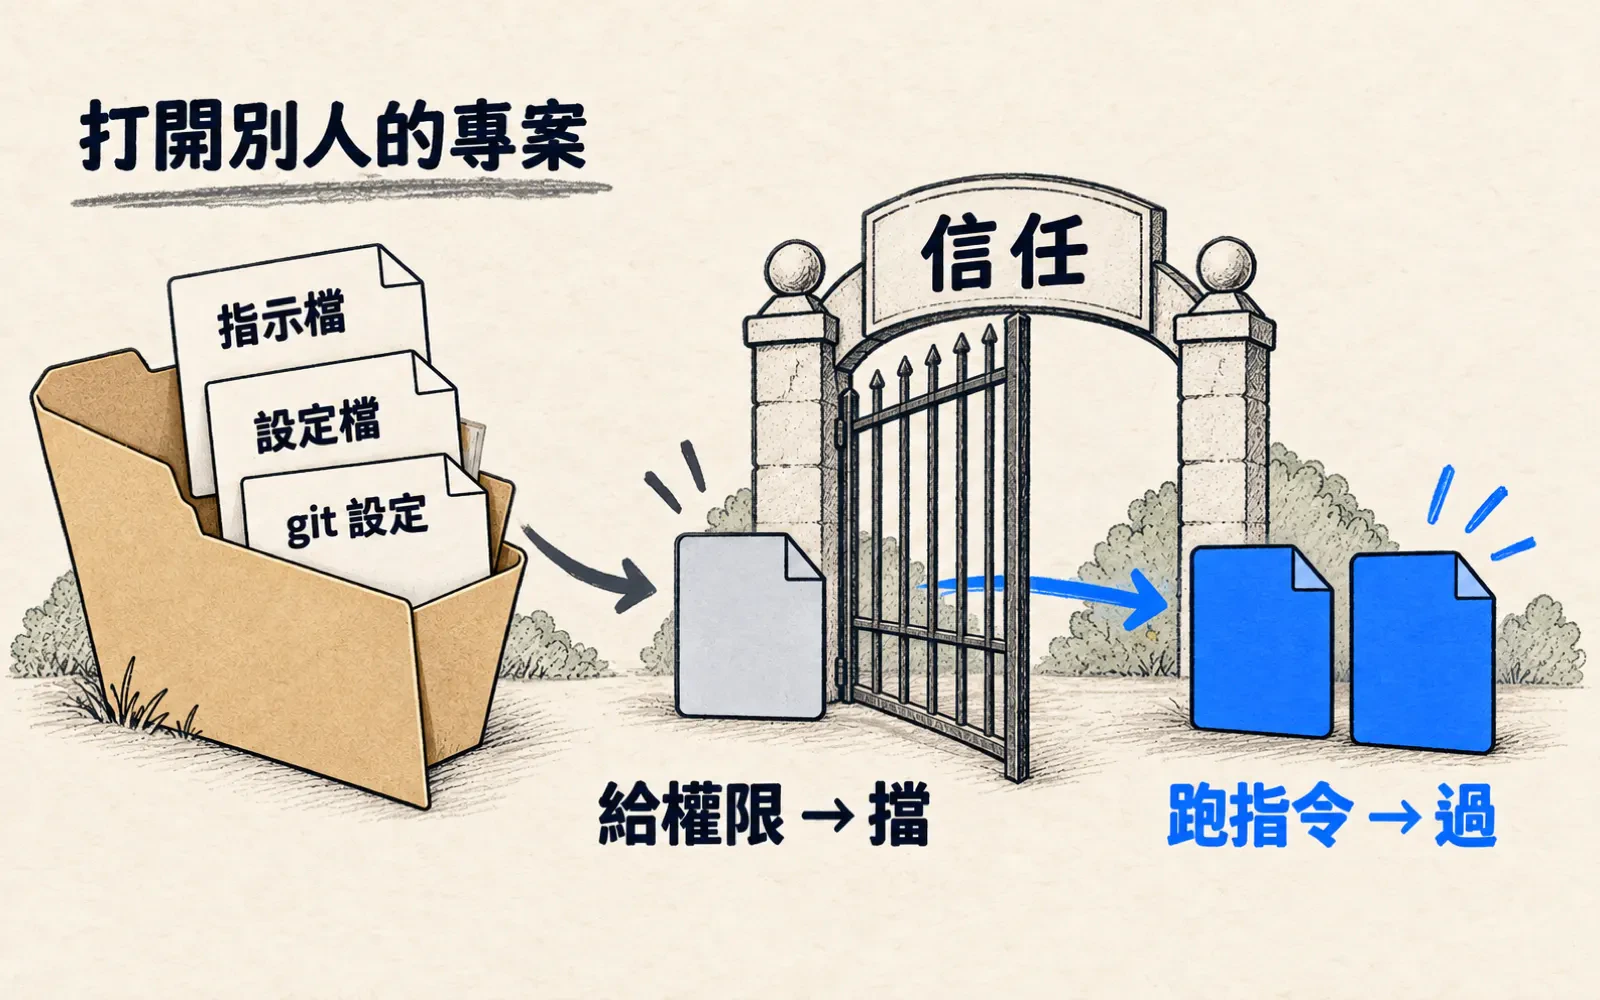
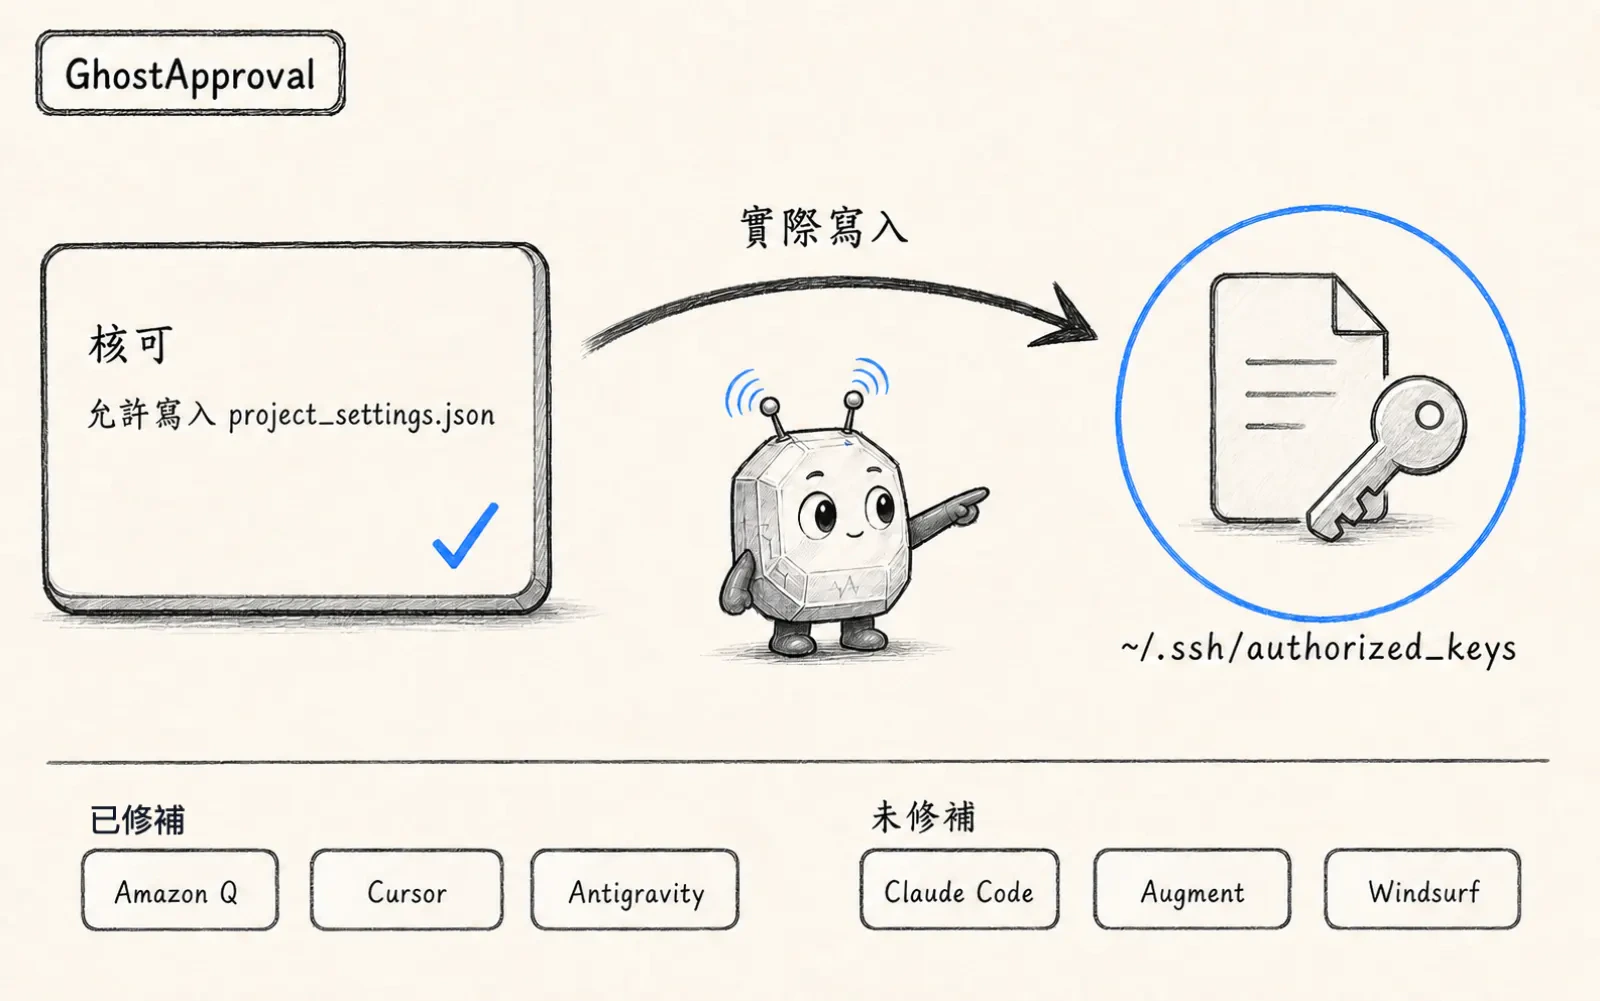
資安研究單位 Wiz Research 查到一種手法,取名 GhostApproval,同一個問題在六款 AI 編碼代理身上都找得到:Amazon Q Developer、Claude Code、Cursor、Google Antigravity、Augment、Windsurf。手法很直接——攻擊者在 repo 裡放一個符號連結(symlink),偽裝成一個看起來人畜無害的設定檔,實際指向你機器上的敏感檔案,比如 SSH 金鑰。代理照著指示去改那個「設定檔」,核可對話框顯示的卻是偽裝後的檔名,不是真正被改動的那個路徑。Wiz 自己講得很白:「人在迴圈裡」這件事只有在核可畫面顯示的是真話時才有意義。
六家的修補進度不一樣。Amazon Q(v1.69.0,CVE-2026-12958)跟 Cursor(v3.0,CVE-2026-50549)修了,Google Antigravity 也修了;Augment 與 Windsurf 到我查核時還沒有修補版本。Claude Code 這邊比較特別——Anthropic 把這份回報標成「不在我們目前的威脅模型內」,官方立場是:你核可的是信任這整個資料夾,不是逐一核可每個寫入動作。這個立場站得住,但代價是讀者要自己知道:在 Claude Code 上,這道口子目前是設計選擇,不是等修補的漏洞。
我的判斷:核可鍵是很多人對「代理有沒有失控」唯一的心理防線,這次證明那個畫面本身可以被騙。我自己現在對不熟的 repo,不會讓代理直接照著陌生的設定檔指示動作,寧可先自己看一眼那個檔案是不是連結。這道口子跟我們上週報過的技能載入信任邊界是同一類問題——代理的信任邊界劃在哪,往往比廠商的功能表更該先搞懂。廠商修補快慢不一致,也呼應了我們整理過的那份事故問責落差:出事之後真正做了什麼,比功能新不新更該放進你的選型清單。
查核備註:Wiz Research 的原始揭露日期為 2026 年 7 月 8 日,我沒有自行重現這個漏洞、也沒有向六家廠商逐一求證修補版本以外的細節;Claude Code 目前的公開立場我引自 Wiz 的報告與 The Hacker News 的轉述,沒有查到 Anthropic 自己發布的正式聲明頁。
LEARN
想系統性學會,不只看這一則?
Claude Code 教學:用終端 AI Agent 完成真正的工作
讓 Claude Code 在你的專案裡完成一個真實任務,而且控得住權限、驗得了 diff、管得住成本。
從第 0 課開始 →SOURCES
- AGhostApproval: A Trust Boundary Gap in AI Coding Assistants
- AClaude Code Docs — Security
- BGhostApproval Symlink Flaws Could Let Malicious Repositories Compromise AI Coding Assistants
- BTop AI Coding Agent security resources — August 2026
來源分級:A = 一手公告/論文/官方文件 · B = 可信媒體 · C = 可參考但需脈絡 · D = 觀察用,不可當事實。
本文由 AI 與編輯共同撰寫,總編輯廖玄同審閱定稿。 編輯方針與 AI 使用說明